Hanzhuo Huang黄涵卓

PhD Candidate · ShanghaiTech University

I work on image and video diffusion models, video world models, and 3D/4D reconstruction and generation — building visual generative models that are consistent, controllable, and physically grounded. Currently a research intern on the Kling Team at Kuaishou.

I will graduate in Summer 2027 and I am actively looking for research positions in world models, 3D vision, and video generation — feel free to reach out!
Hanzhuo Huang

Selected Publications

ContextMaster: Interactive Multi-Shot Video Creation via Fixed-Budget Sparse Context Routing Preprint

Xu Guo*, Zhengxuan Wei*, Xinghui Li*, Hanzhuo Huang, Xinyu Liu, Xiangyang Luo, Min Wei, Yiran Zhu, Qiulin Wang, Yulong Xu, Xintao Wang, Pengfei Wan, Qi Fan, Xiangwang Hou

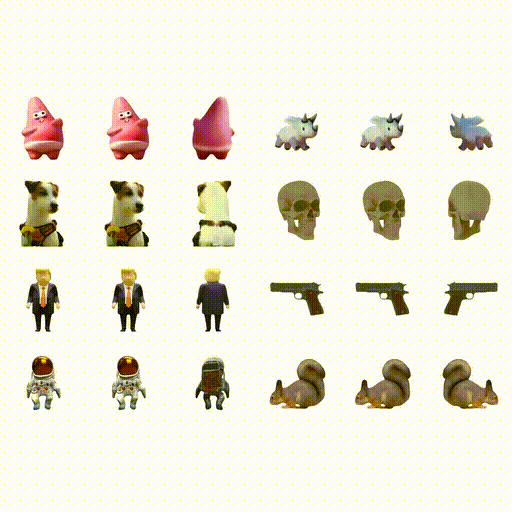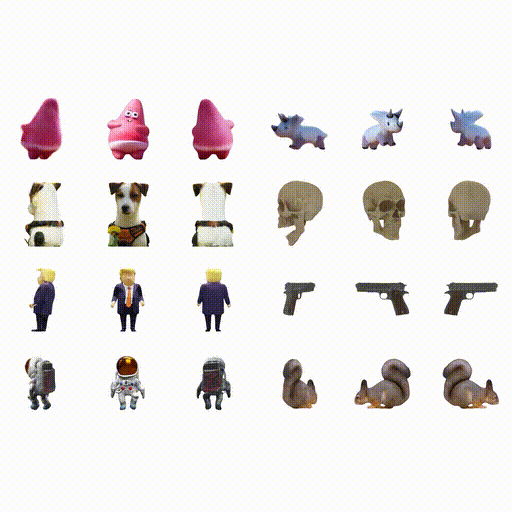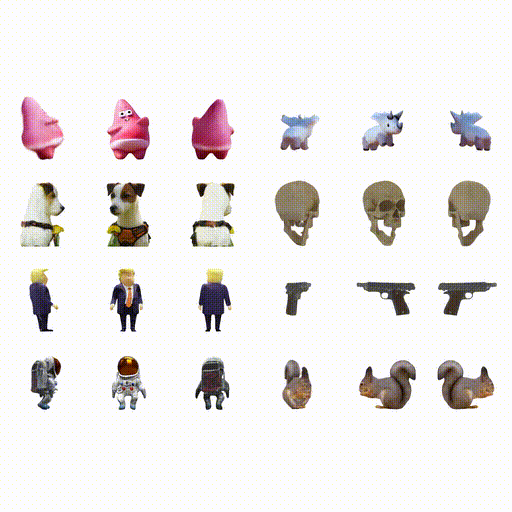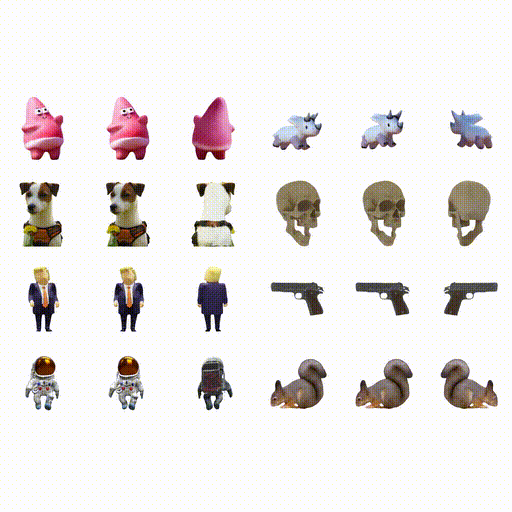
RefAny3D
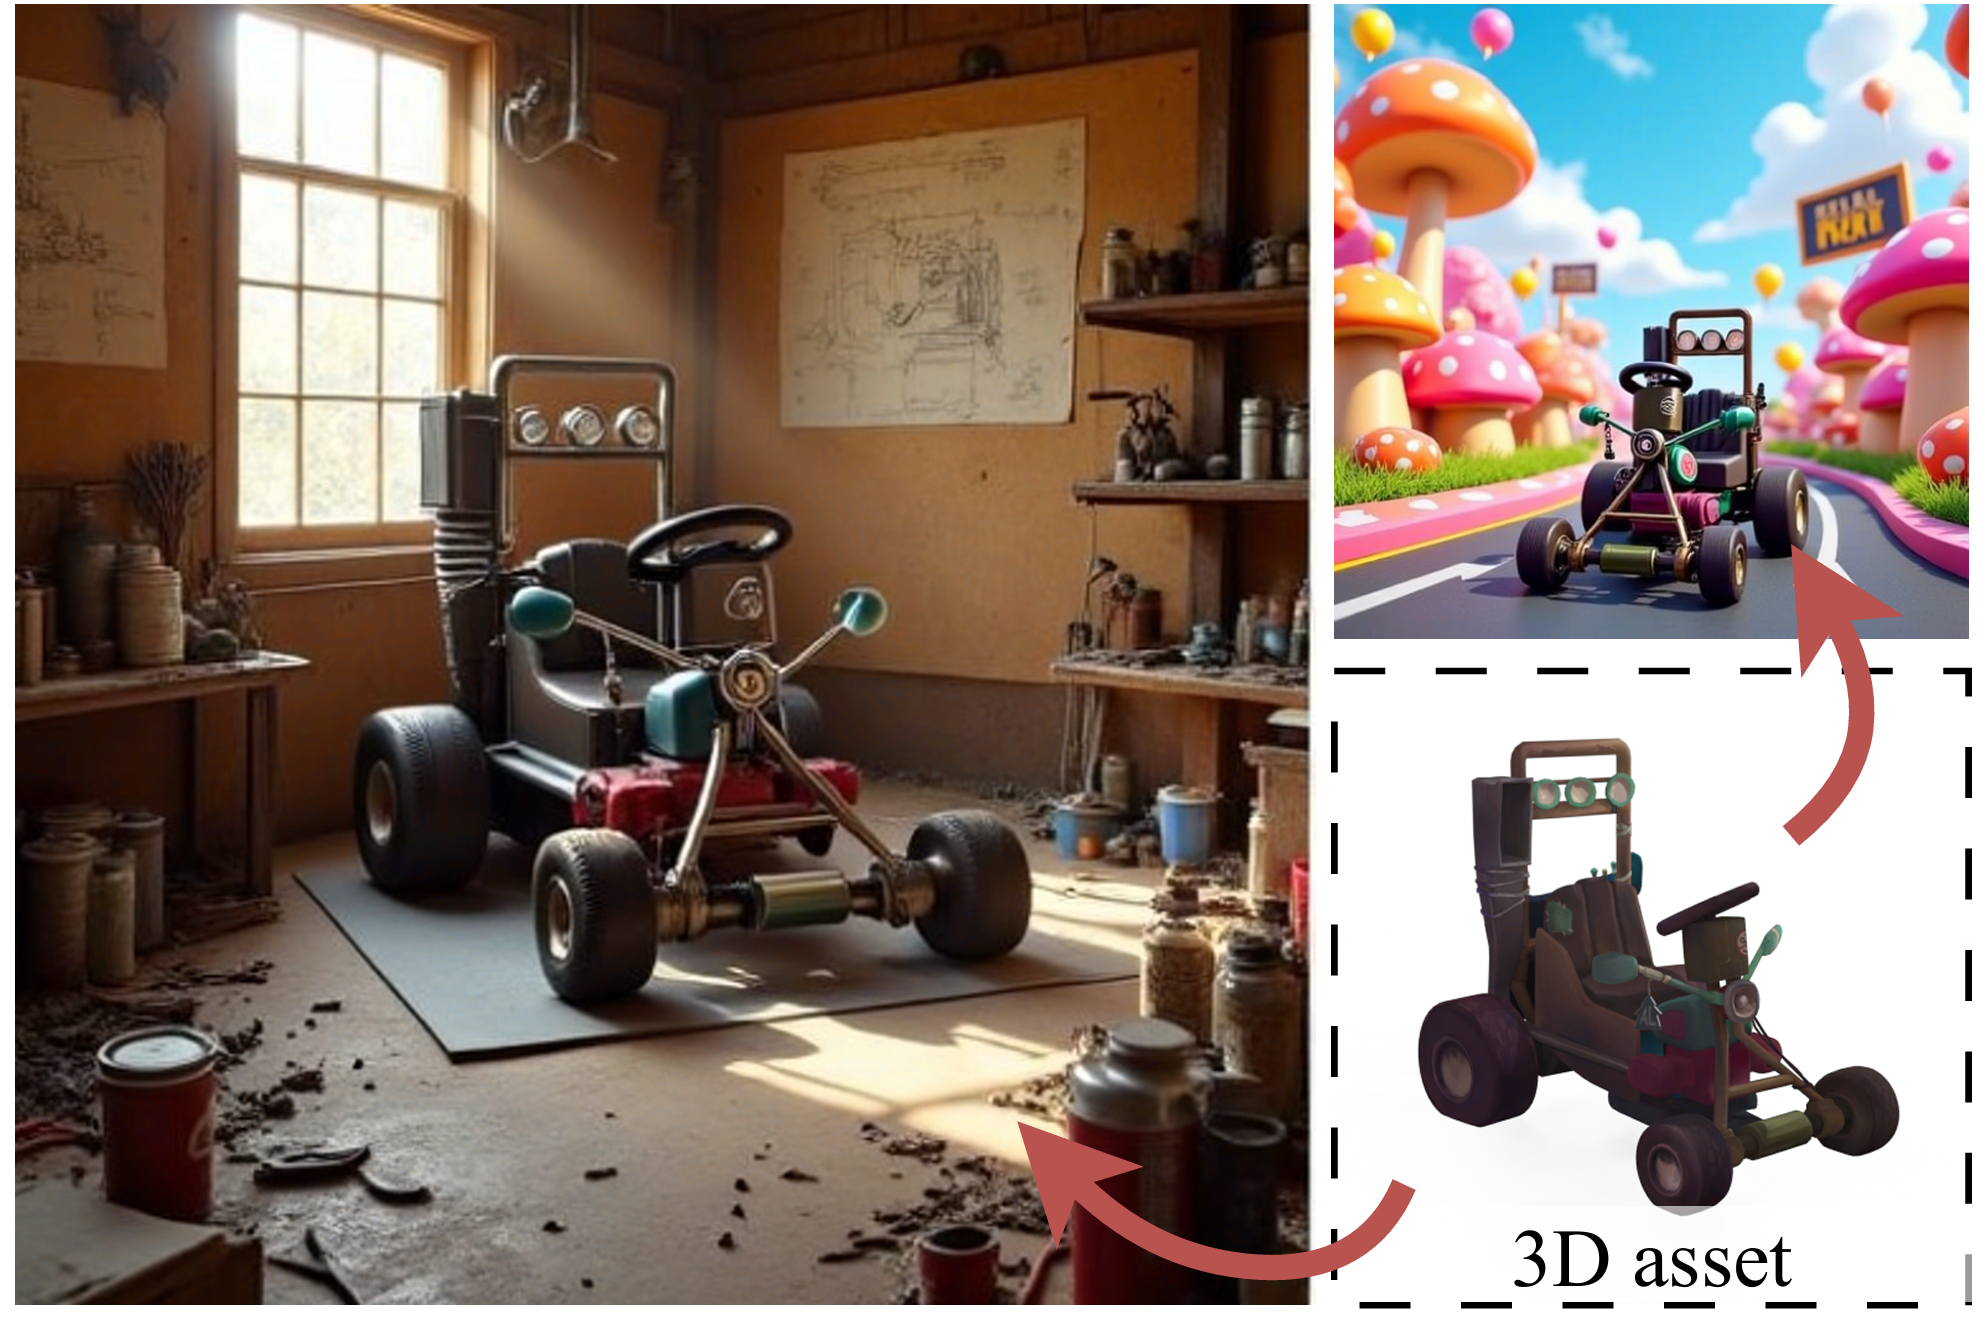
RefAny3D: 3D Asset-Referenced Diffusion Models for Image Generation ICLR 2026

Hanzhuo Huang, Qingyang Bao, Zekai Gu, Zhongshuo Du, Cheng Lin, Yuan Liu†, Sibei Yang†

GO-Renderer: Generative Object Rendering with 3D-aware Controllable Video Diffusion Models ECCV 2026

Zekai Gu, Shuoxuan Fang, Yansong Wang, Hanzhuo Huang, Zhongshuo Du, Chengfeng Zhao, Chengwei Ren, Peng Wang, Yuan Liu†

UniRecGen: Unifying Multi-View 3D Reconstruction and Generation SIGGRAPH Asia 2026

Zhisheng Huang, Jiahao Chen, Cheng Lin, Chenyu Hu, Hanzhuo Huang, Zhengming Yu, Mengfei Li, Yuheng Liu, Zekai Gu, Zibo Zhao, Yuan Liu, Xin Li, Wenping Wang†

MVTokenFlow
MVTokenFlow: High-quality 4D Content Generation using Multiview Token Flow ICLR 2025

Hanzhuo Huang*, Yuan Liu*, Ge Zheng, Jiepeng Wang, Zhiyang Dou, Sibei Yang†

Compositional Hallucinations
Discovering Compositional Hallucinations in LVLMs NeurIPS 2025

Sibei Yang†, Ge Zheng, Jiajin Tang, Jiaye Qian, Hanzhuo Huang, Cheng Shi

Adaptive Part Learning
Adaptive Part Learning for Fine-Grained Generalized Category Discovery: A Plug-and-Play Enhancement CVPR 2025

Qiyuan Dai, Hanzhuo Huang, Yu Wu, Sibei Yang†

Free-Bloom
Free-Bloom: Zero-Shot Text-to-Video Generator with LLM Director and LDM Animator NeurIPS 2023

Hanzhuo Huang*, Yufan Feng*, Cheng Shi, Lan Xu, Jingyi Yu, Sibei Yang†

* equal contribution  ·  † corresponding author

Experience

Research Intern · Kling Team, Kuaishou

Video world models · Embodied AI

May 2026 — Present

Research Intern · Megvii Research

Multi-view diffusion models

Jun 2023 — Dec 2023